这个字符编码转换工具, 它的核心作用是把一串同样的字符从一个编码格式转换成另外一种编码格式, 比如从 UTF-8 转换成 GBK, 或者是反过来操作。在选择使用哪个工具的时候, 你需要看三个方面的情况: 第一个方面是因为你的目标场景是需要处理批量文件呢, 还是说需要处理实时的数据流?
第二个方面是你是否需要让工具去处理那些非法的字节? 第三个方面是你的运行环境是不是允许安装依赖包。
在命令行环境下, 大家可以去使用 iconv 这个程序, 要是想在代码开发过程中处理的话, 就去调用 Python 里的 codecs 模块或者是 str.encode() 方法, 对于那些只需要临时查一下数据的场景来说, 在线工具会更适合一些, 目前这个世界中并不存在所谓的万能工具, 大家找到的, 只能是恰好能够解决眼前那一类问题的合适工具。
字符编码转换工具解决什么问题
计算机里面存储的东西是字节流, 对于“你好”这个词来说, 它要是放在 UTF-8 那种编码方式里, 就要占据 6 个字节的长度, 可要是把它放进 GBK 这个编码格式里去的话, 就只需要占用 4 个字节了, 专门用来做编码转换的这种工具所要执行的操作, 其实就是按照一定的规则, 把那个字节流重新进行映射处理, 具体是怎么做的?
它是先根据原始的源编码, 把那些字节给解码成为 Unicode 码点, 然后再接着去根据目标所指定的编码, 把这些码点又再次地编码成字节。
需要处理的典型场景包括遗留系统导出的 GBK 文本要接入 UTF-8 数据库, 网页 meta 标签里写的是 ISO-8859-1, 可是实际内容其实是 UTF-8, 还有跨平台交换 CSV 文件的时候, CRLF 和编码会同时出错。
主流工具对比与适用边界
| 工具 / 方式 | 适用场景 | 优势 | 限制 |
|---|---|---|---|
GNU iconv(Linux/macOS 自带) |
批量文件、管道处理 | 无依赖,速度快,支持 200+ 编码 | 遇非法字节默认报错终止,需加 -c 跳过 |
Python codecs / str.encode() |
应用内处理、流式转换 | 灵活,可自定义错误处理(errors='replace') |
大文件需分块读,内存占用高 |
| 在线转换网站(如 ConvertCharSet) | 临时验证、小段文本 | 零安装 | 文本有长度上限(通常 10 000 字符左右),不适合生产 |
Java Charset / .NET Encoding |
对应生态内的项目 | 与语言标准库一体 | 需写代码,不适合一次性操作 |
请按照测试环境的设置进行核对操作, iconv 这个工具在 Debian 12 这个系统上, 默认情况是可以支持 UTF-8 , GBK , GB18030 , Big5 , Shift_JIS , ISO-8859-1 这些字符集的, 但是需要注意的是, Shift_JIS这个方法针对4字节增补字符的问题是无能为力的, 比如说有一些 emoji 表情就是这样, 因为它根本无法处理编码工作, 所以最终会返回 “cannot convert” 报错信息给用户。
这是实际存在的限制, 而不是我们所说的bug。
操作步骤与关键参数
第一步是打开命令行工具,第二步是使用名为iconv的命令功能,第三步则是完成整个操作流程:这三个步骤加起来就搞定了。
1. 确认源编码, 具体操作是用“file -i input.txt”这个命令, 如果输出的结果里面有“charset=unknown-8bit”, 这就说明没有BOM头, 这时候就需要人工来判断, 或者去看一下来源文档。
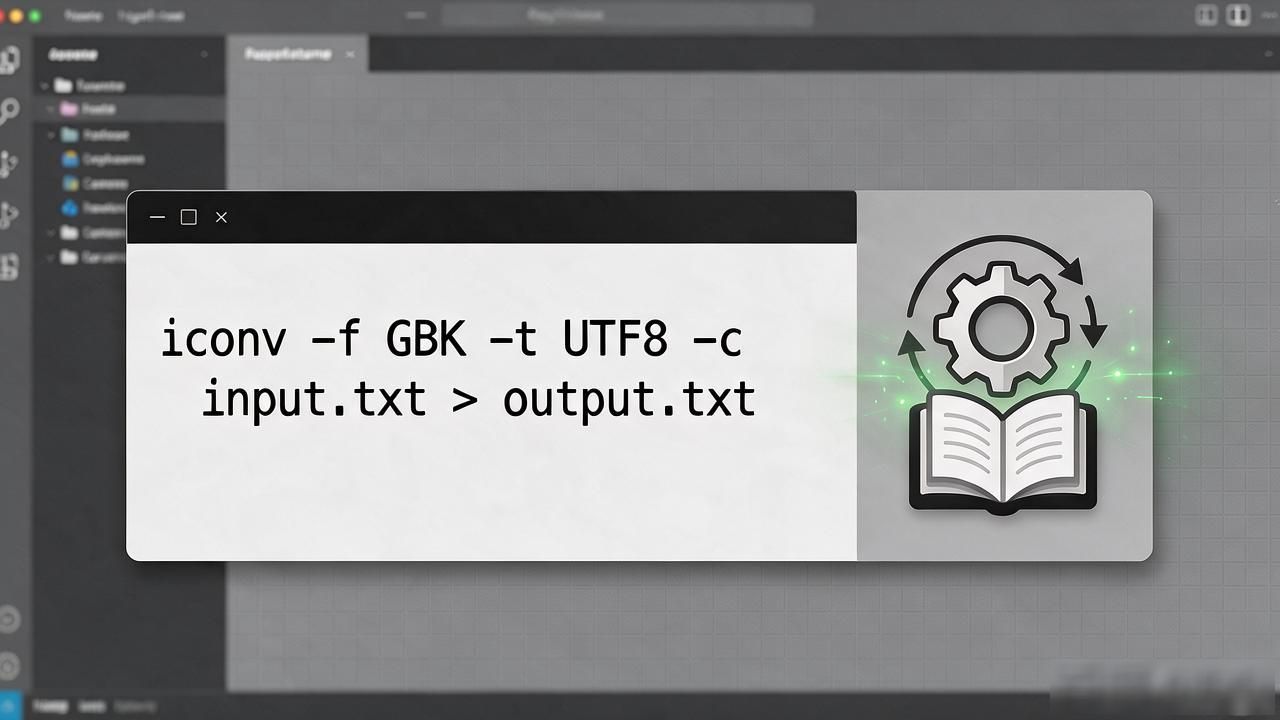
2. 执行转换:iconv -f GBK -t UTF-8 -c input.txt > output.txt
-f 以及 -t, 这俩参数, 指的是源编码和目标编码, 你要是不小心把这方向给写反了, 那出来的结果, 就会是一堆让你看不懂的东西, 也就是人们常说的乱码。
对于-c这种选项, 就是在碰到那些没办法进行转译的字节的时候, 它会直接跳过过去, 并且把一些警告信息给输出到 stderr 这个标准错误流里面去, 而不是说就直接终止掉整个程序或者进程。
所以在生产环境当中的时候, 非常建议大家把这个选项给加上, 这样做的目的是为了能够避免因为某一个坏的字节的原因, 从而就毁掉掉了你整一批次的这些数据或者是文件什么的。
在不加 -c 这种情况下, iconv 会在碰到第一个非法字节的时候直接停止运行, 之前已经转换成正常内容的部分, 会按照原本的方式被写入到目标文件里。
3. 校验:iconv -f UTF-8 -t UTF-8 output.txt > /dev/null,返回码 0 说明目标文件是合法 UTF-8。
这里有两行核心代码,这些代码的用处是Python语言相关的。
raw = open('legacy.txt', 'rb').read()
text = raw.decode('gbk', errors='replace')  # 非法字节用 ? 替代
out = text.encode('utf-8')
errors 这个参数的取值有四种, 它们分别是strict(它是默认值, 一旦遇到错误就会抛出异常)、replace、ignore, 以及surrogateescape, 至于说具体选择哪一个, 这完全是取决于你是否允许数据丢失这件事。
容易踩的坑与失败表现
BOM 污染:UTF-8 with BOM 文件用 iconv -f UTF-8 转换后,开头会多出 xEFxBBxBF 三个字节。处理:先 sed '1s/^xEFxBBxBF//' file 去掉 BOM,或 iconv 指定 -f UTF-8-BOM(GNU 0.19+ 支持)。
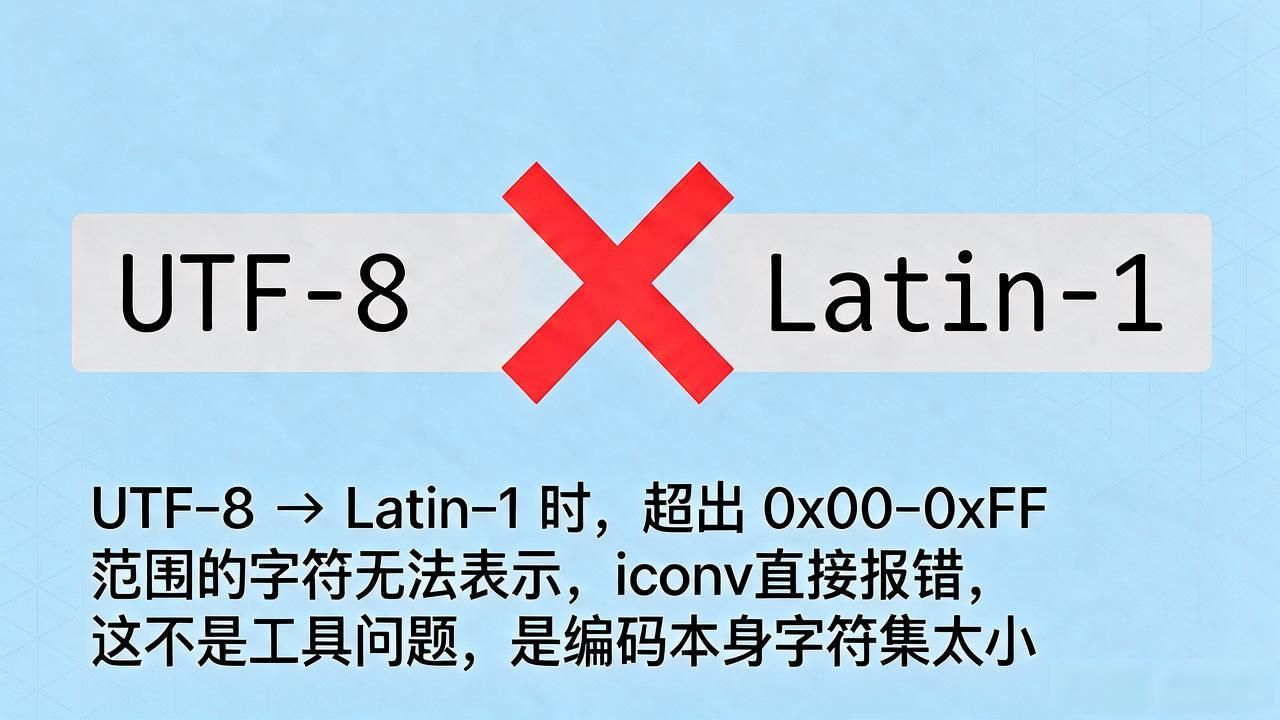
当进行不可逆转换, 把 UTF-8 格式的数据转成 Latin-1 格式的时候, 凡是超出了 0x00 到 0xFF 这个范围的那些字符, 比如说中文之类的这些字符, 它们就没法被表示出来, 这时候 iconv 这个工具就会直接给出一个报错的信息。
这根本就不是什么工具的自身问题, 而是 encoding 编码本身它的字符集大小实在太小了所造成的后果。
GBK对GB18030的关系是这样的, GBK 这个编码其实是 GB18030 编码的一个子集。要是你用 -t GBK这样的参数去试图转换包含生僻字的文本内容就会失败, 例如“镸”字就没办法正常处理。
这时候你只需要把参数改成 -t GB18030就可以了。在很多时候, 那些工具类的文档里面, 通常会只写出GB2312还有GBK这些东西, 压根就不去区分什么GB18030, 这确实是一个非常频繁会出现错误的地方。
在线工具截断: 如果你在粘贴文本的时候, 输入的内容超过了工具设定的上限数值, 那么后面的那一部分内容就会被直接丢弃掉, 系统不会给你任何提示。所以如果处理的是长文本,务必须要使用本地工具才行。
选型建议(按场景)
针对一次性、几百行以内的文本, 使用在线工具或者 iconv 这一行命令就足够了。
百万行级日志批量转码:iconv -c 管道 + xargs 分片,避免单文件 4 GB 限制。
在应用程序的内部, 持续地处理来自用户的输入内容时, 你可以调用编程语言自带的库功能, 例如说Python里的codecs库或者Java里的Charset类, 把这些用来应对错误的策略参数配置成replace这个值, 同时把情况记录到日志里面去, 切记不要把策略设置成strict, 如果那样的话, 系统会直接返回一个500错误状态码。
需要使用可以保留那些没有办法被编码的字符的本来的样子, 也就是用到 surrogateescape, 它是 Python 里的东西, 或者用到 Encoding.ReplaceFallback, 它是 .NET 里的东西, 以此来保证在解码然后是编码的这个往返的过程中, 不会丢掉任何一个字节。
FAQ
人们在使用字符编码转换工具的时候, 能不能够把那些已经出现了乱码状态的文件给修复到位呢。
无法进行自动化修复的操作。乱码的出现表明原始的字节数据已经被错误地读取, 转换工具仅能够按照你所指定的编码方式来重新解读这些数据。倘若选择的编码方式出现判断错误, 那么生成的结果将会变得更加混乱。
建议首先使用 hexdump 命令查看文件的前几十个字节的十六进制内容, 以此来辨别是否存在 BOM 标记或者特定的字节排列模式, 然后据此来选择合适的编码格式。
你想问一下, iconv -c 这个参数会不会导致数据丢失。
会, 被跳过的字节不会出现在输出里面, 但是会被写到标准错误的那个警告信息里, 生产流程需要去捕获标准错误, 并且统计一下跳过的数量, 如果发现超过了规定的阈值就要去报警。
在GBK编码和GB18030编码之间, 人们究竟应当怎样来进行实际的选择?
GBK, 这个编码标准, 它大概能覆盖两千个汉字左右的数量级, 具体来说, 是大约两万多个汉字。而GB18030, 这个编码标准, 它的覆盖面要大得多, 能够达到二十七万以上的汉字数量。这里面还包含了那些少数民族的文字, 以及日常生活中比较少见的生僻字。
如果你的文本内容里面, 主要都是常用的汉字, 那么使用GBK这种编码方式, 会有更好的兼容性表现。但是, 如果你的应用场景涉及到了正式出版的工作, 或者是需要处理很多生僻字的时候, 那么你应当选择使用GB18030这样一个编码方式来确保不出错。
那个叫做在线字符编码转换工具的东西, 它的安全性问题现在是大家都会去考虑的一个事情。
这段话会被传到对方的服务器上面去。那些属于国家秘密或者是特别敏感的数据, 坚决不能用在在线的工具里去处理。应该选择在本地的电脑上进行操作, 可以使用 iconv 这个命令工具, 也可以运行一些自己写的脚本程序, 这样做的好处是它不会连接到网络上去。
参考资料
1. GNU Core Utilities – iconv 官方手册(文档更新于 2024):https://www.gnu.org/software/libiconv/
2. Python 官方文档 – encodings: Unicode Error Handlers:https://docs.python.org/3/library/codecs.html#python-encodings
3. W3C / IETF – UTF-8 and UTF-16 in XML (RFC 3629):https://www.ietf.org/rfc/rfc3629
免责声明:网所有文字、图片、视频、音频等资料均来自互联网,不代表本站赞同其观点,内容仅提供用户参考,若因此产生任何纠纷,本站概不负责,如有侵权联系本站删除!邮箱:207985384@qq.com https://www.ainiseo.com/jishu/61545.html