GBK 它是 GB18030 的子集, 同时也常被称为 Windows936 或者 ANSI, 这是中文版的 Windows 系统里面默认的编码格式, 而 UTF8 这个编码, 它是用来在网络上使用, 也是国际标准里采用的编码方式。
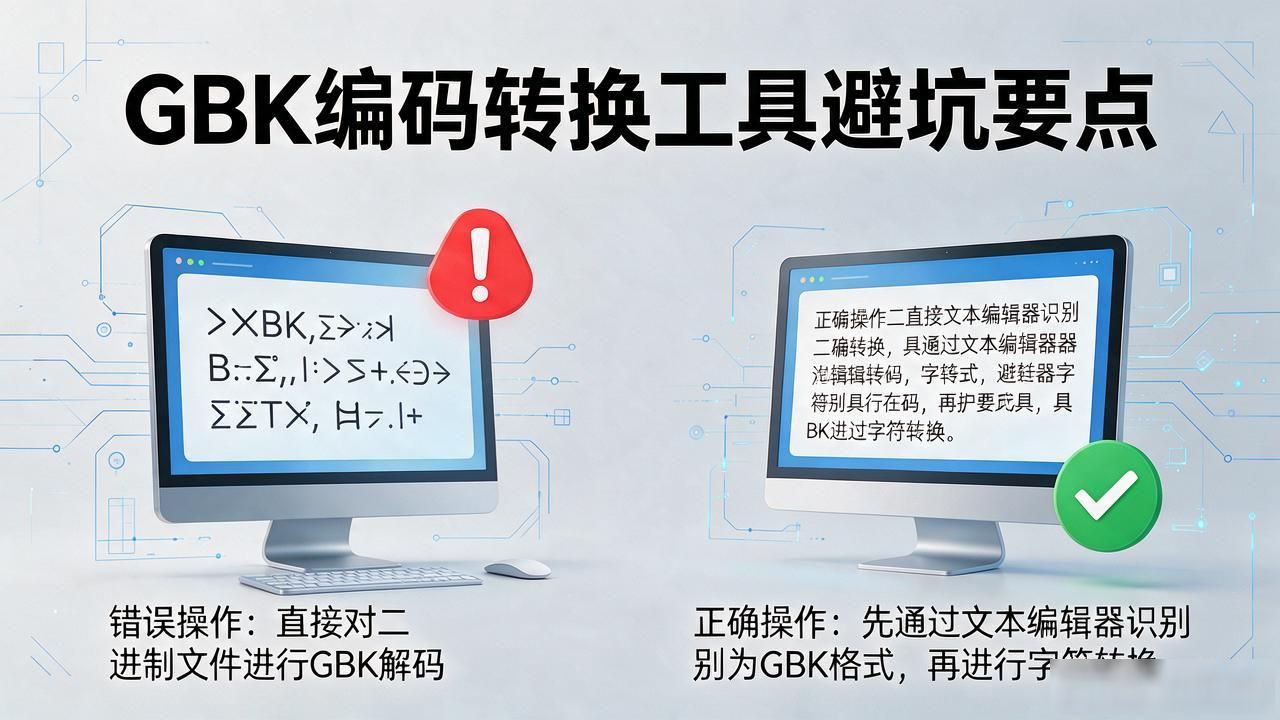
把这两种不同的编码混在一起使用的时候, 中文汉字所对应的字节序列是不一样的, 如果不对转码就直接去打开文件, 屏幕上显示出来的就会全是乱码代码, 实际上进行转换这一动作本身并不复杂,最关键的环节在于你要选对正确的工具, 并且在动手操作之前先去确认清楚源文件本身的编码格式到底是什么, 然后再开始进行操作。
在下面这部分内容里, 会把5种常用的工具一一列出来, 同时也会把这些工具的适用场景说明白, 还会针对文件操作、数据库操作以及网页操作这三种比较有代表性的情形, 把具体的操作路径讲清楚, 并且会指出这些操作过程之中比较容易出现错误、需要大家特别留意的地方。
GBK与UTF-8乱码的底层原因
乱码这种状况, 其实并不是文件损坏了, 而是这些字节被用错误的方式去解读了。因为GBK这种方式是用一到两个字节来表示一个汉字的, 但是UTF-8这种编码方式则需要用三个字节来表示。
当把GBK格式的文件当作UTF-8格式的文件来打开的时候, 原本占一个字节的第二个字节的数值如果在0xE0到0xEF这个范围的开头那个字节上, 它就会被系统误认为是多字节序列的起始字节, 这样一来, 后面的那些字节顺序就全部错位了, 结果整一行显示出来的内容就变成了问或者是方框这样的字符。
判断源文件的编码方式, 绝对不能仅仅凭借那种看起来像是随机乱码的表象作为唯一的依据。在Windows系统下, 你可以通过使用由Git Bash提供的file命令进行查看, 也可以检查Notepad++软件右下角所处的状态栏来确认编码类型。
当处于Linux环境中时, 你可以调用file -i指令, 或者执行像iconv -f GBK -t UTF-8 测试文件这样的转换操作去处理相关的测试数据。倘若运行过程中未出现任何的错误提示代码, 那么即意味着源文件的编码确实属于GBK格式。
要是那个源文件自己里头就混着不同的编码格式, 比如说一部分是GBK编码, 另一部分是UTF-8编码, 那么光是用iconv这个命令来处理的话, 程序是会突然中断的, 所以这个时候得一行一行地去进行检测, 具体的操作办法, 可以在后面看到的那些需要避开坑的地方找到相关说明。
5款常用转换工具对比
| 工具 | 类型 | 适用场景 | 优点 | 限制 |
|---|---|---|---|---|
| Notepad++(64位) | GUI编辑器 | 单文件、<50 MB文本 | 可视化编码切换,改完直接另存为 | 大文件卡顿;无法批量 |
| iconv(系统自带) | 命令行 | Linux/CI脚本、批量 | 速度快、可嵌脚本 | 遇到非法字节默认报错中断 |
Python codecs / chardet |
脚本 | 混合编码、需容错处理 | 可指定errors='replace'跳过坏字节 |
需Python环境 |
mysqldump + --default-character-set |
数据库工具 | MySQL/MyISAM表 | 官方导出通道 | 仅覆盖SQL层面,存储引擎内编码不变 |
| VS Code + 扩展(如Chinese GBK) | 编辑器 | 开发中临时查看GBK源码 | 零配置、IDE内完成 | 批量转换需配合任务脚本 |
根据Python3.13版官方文档中关于codecs这个模块的说明文字, 如果我们使用open函数来打开那个叫作f.txt的文件, 并且指定参数编码方式为gbk, 错误处理方式为replace, 那么这个操作是可以安全地读取到含有坏字节的GBK格式文件的, 这种情况下它会把那些坏的字节替换为U+FFFD这个字符, 而不是直接抛出异常内容, 所以说这种做法算是去处理那些半截字节时最稳妥的一种写法方式了。
三种场景的操作要点
文本文件批量转换(Linux服务器)
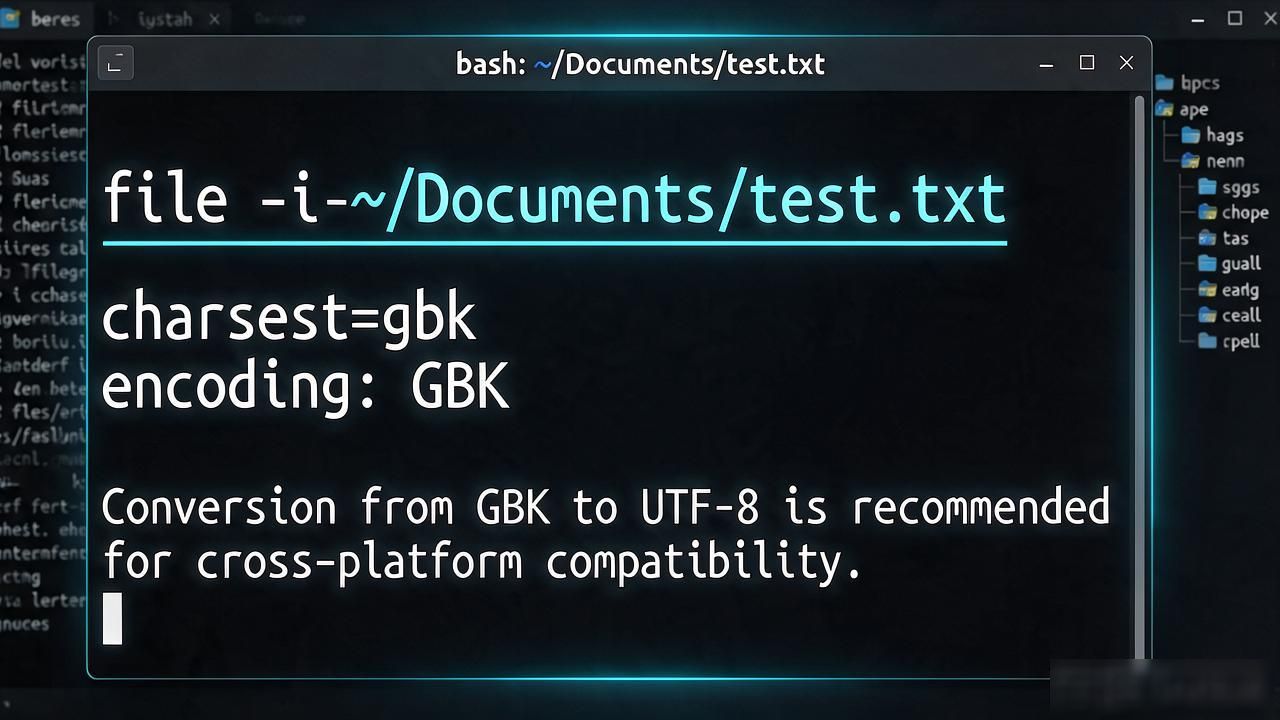
1. 确认源编码的具体做法。先运行file -i .txt这个命令。输出的结果里面应该含有charset=gbk。或者输出结果里面含有iso-8859-1。因为GBK在Linux系统的file命令执行时。经常被错误地标识为iso-8859-1。所以需要以实际的文件内容作为判断的依据。
2. 把.txt里面的各个文件都进行批量转换, 方法是对文件名字符串f执行这样一段操作, 也就是for f in 后面带着这些文件名, 然后进入循环体里做iconv这个命令行工具的操作, 具体是把GBK编码转换成UTF-8编码, 输入的是那个文件名的字符串表示形式, 输出是指定了前缀的新的文件名对应的文件。
3. 我们要进行验证工作, 具体的方法是随机挑选出三个文件, 然后使用hexdump -C这个工具来对它们的首行汉字字节情况进行对比, 在=UTF-8这个编码环境下, 汉字”中”所对应的内容应该为e4 b8 ad。
MySQL数据库(GBK→UTF8MB4)
MySQL官方文档指出,ALTER TABLE ... CONVERT TO CHARACTER SET utf8mb4会同时修改列定义和数据。操作前必须:
先备份:mysqldump --default-character-set=gbk -u root -p 库名 > backup.sql
修改my.cnf中character-set-server=utf8mb4、collation-server=utf8mb4_general_ci
在系统重新开启之后, 需要分库分别地去执行ALTER语句。这样做的目的是为了不让数据库锁表的时间变得太长。对于数据量非常大的表, 我们建议去使用pt-online-schema-change这个工具来进行在线的结构变更操作。
网页/前端项目
HTML文件改为utf-8后,需确认所有.js、.css、.json文件也同步转换,否则浏览器按UTF-8解析时JS字符串仍为GBK字节,控制台会报SyntaxError: Invalid or unexpected token。
常见失败场景与避坑清单
出现了iconv报错”Illegalbytesequence”的问题。这说明源文件里面并不是纯粹的GBK编码。它可能混有其他部分,比如那些使用UTF-8编码的内容, 或者还包含了BOM标记。
我们应该使用Python程序来读取这个文件,并且对每一行代码都用尝试和捕获异常的机制去处理。如果遇到处理失败的行。就把这一行的情况记录到日志里面, 然后单独去进行修复。绝对不要让程序强行进行转码操作。try/except是用来做这种处理的常用方法。
转换后数字/特殊字符异常: 在GBK中, 0xA1到0xFE的区域代表全角ASCII区, iconv工具默认会把这些字符映射成对应半角的状态。如果业务逻辑上依赖全角空格来达到中文表格对齐的效果, 那么在完成转换之后, 需要人工进行校验。
WindowsNotepad++保存时勾选了”UTF-8-BOM”, 这意味着PHP的标签前面会多出3个字节Bom内容, 从而导致php -l这个命令报告语法存在错误, 解决办法是当你在保存文件的时候, 应该选择那个叫作"UTF-8(无BOM)”的选项来进行存档操作。
数据库连接串未改: 虽然修改了表的编码, 但是应用程序里的连接字符串仍然写的是 characterEncoding=gbk。
这会导致在读写数据的时候, 多产生一次隐藏的转换操作, 不仅性能的下降会很明显, 而且可能出现 emoji 字符丢字的现象。Java应用的连接串必须要改成 characterEncoding=utf8mb4。
FAQ
很多人会在意那个问题, 就是GBK转为UTF-8之后, 大文件的大小会变大了吗。
这种情况通常都会出现的。因为当一个汉字编码格式从GBK的2字节变成了UTF-8的3字节之后, 整个纯中文文件总体积大约就会增大百分之五十这样的比例。但是ASCII字符的体积是保持不变的。
iconv和Python的codecs模块哪个更快?
当数据是以纯批量方式处理, 且文件里不存在坏字节的时候, 使用C语言实现的那个iconv工具, 执行速度是快于Python的。
但如果场景要求混合各种编码格式, 又或者需要对错误情况进行容错处理, 那么使用Python就会变得更加灵活自如一些。并且, 其codecs模块的源码内容, 是可以直接在CI(持续集成)环境中对逻辑部分进行审计检查的。
转换后如何验证没有丢字?
要对同一文件之中的字符的数量进行对比, 你可以使用wc -m这个命令。此外的话, 还有一种办法就是在LC_ALL=C环境设置下, 先运行wc -c命令, 然后把得到的结果除以3来进行粗略的估算。
另外一种方法是直接使用Python程序, 你可以写一段代码, 比如len(list(open(f, encoding='utf-8').read())), 这样也能够达到相同的目的。若字符数一致、无U+FFFD,说明无丢失。
在当前使用的这个windows系统环境之下, 因为并不存在相应的linux工具链, 所以对于应该怎么来执行批量转换这一件事情, 是需要进行具体考虑的。
通过运行PowerShell指令, 使用Get-ChildItem_命令找到所有文本文件, 然后对每个文件进行处理, 调用_System.Text_Encoding类中的GetEncoding方法, 指定GBK编码格式, 再读取当前文件的完整路径对应的二进制字节内容, 将其转换为普通字符串, 接着把这些字符串输出到外部, 并用Out_File指令来写入一个新的文件, 这个新文件的编码格式被设置成utf8, 文件的路径是在原来的文件名后面加上_utf8.txt的后缀。
注意-Encoding utf8在PS 5.x默认带BOM,需改用[System.IO.File]::WriteAllText指定UTF8Encoding($false)。
参考资料
1. Python官方文档 – codecs模块:https://docs.python.org/3/library/codecs.html
2. MySQL 8.0 Reference Manual – Character Set Configuration:https://dev.mysql.com/doc/refman/8.0/en/charset-connection.html
3. 国际互联网号码分配机构, 也就是大家熟知的IANA, 这个机构的官方注册字符集列表里头, 专门给GBK和GB18030这两个编码标准留出了对应的条目记录。https://www.iana.org/assignments/character-sets/character-sets.xhtml
风险提示:,编码转换这件事涉及到一个不可逆的字节重新映射的操作, 所以在动手操作之前, 一定要先把原始文件进行备份。对于数据库的变更这件事, 请先在测试环境里面进行验证, 确认没问题之后, 再上到生产环境里去运行。
这篇文章的内容是基于上述所说的这些官方文档整理出来的, 具体怎么个版本行为, 要以你自己在用的那个软件版本的官方说明为准。如果发现这里面的信息已经过时了, 那就请以上面那个链接里面的最新内容为准。
免责声明:网所有文字、图片、视频、音频等资料均来自互联网,不代表本站赞同其观点,内容仅提供用户参考,若因此产生任何纠纷,本站概不负责,如有侵权联系本站删除!邮箱:207985384@qq.com https://www.ainiseo.com/jishu/61561.html